Situación inicial
¿Por qué aparece «España»?
Cuando un programa interpreta unos bytes con una codificación distinta de la usada al guardarlos, aparecen caracteres extraños. Para leer correctamente necesitamos acordar cómo pasar de caracteres a números y de números a bytes. Una fuente tipográfica dibuja los símbolos; la codificación indica cuáles son.
ASCII asigna códigos de 0 a 127 a 128 caracteres, suficientes para letras inglesas, dígitos y controles básicos. Se define con 7 bits, aunque sus códigos suelen almacenarse en bytes. No hay una única tabla universal de «ASCII extendido»: existen distintas codificaciones de 8 bits, con asignaciones diferentes por encima de 127.
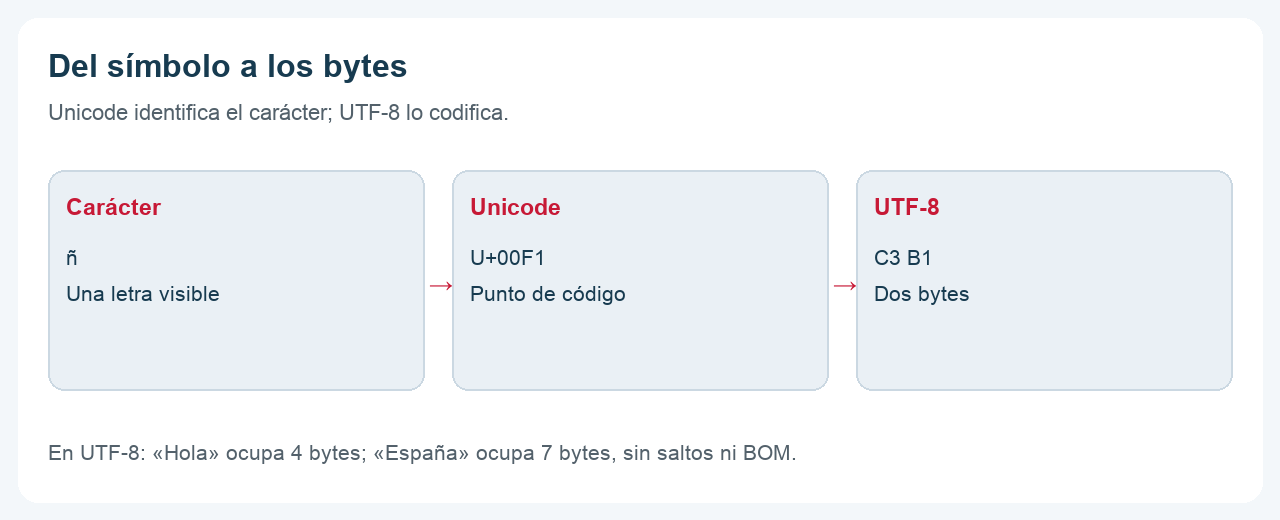
Unicode establece un repertorio y puntos de código, como U+0041 para A y U+00F1 para ñ. No obliga a guardar cada carácter con 32 bits. UTF-8 es una forma de codificar los puntos de código Unicode en secuencias de 1 a 4 bytes. Los códigos ASCII conservan su valor y ocupan un byte en UTF-8.
Ejemplo resuelto · «Hola» y «España»
| Carácter | Punto de código | Bytes UTF-8 en hexadecimal |
|---|---|---|
| H | U+0048 | 48 |
| o | U+006F | 6F |
| l | U+006C | 6C |
| a | U+0061 | 61 |
| ñ | U+00F1 | C3 B1 |
«Hola» ocupa 4 B en UTF-8: 48 6F 6C 61. La H se representa como 01001000₂. «España» tiene seis letras, pero ocupa 7 B: 45 73 70 61 C3 B1 61. La ñ ocupa dos bytes, no uno. Estos tamaños corresponden solo al texto, sin salto de línea, marca BOM ni cabecera.
Carácter visible no siempre equivale a un punto de código
La letra á puede guardarse como U+00E1 o como una a seguida de un acento combinante. Se ven prácticamente igual, pero la secuencia de códigos y su longitud pueden diferir. Algunos emojis visibles reúnen varios puntos de código. Por eso, «número de letras», «puntos de código» y «bytes» no son medidas intercambiables.
Práctica guiada · Investiga tus propios bytes
Guarda dos archivos de texto plano en UTF-8: uno con «Hola» y otro con «España», sin comillas. Utiliza un editor que muestre codificación y un visor hexadecimal. Anota los bytes y compáralos con la tabla. Si el tamaño es mayor, busca un salto de línea: LF añade 1 B y CRLF añade 2 B; una BOM de UTF-8 añade 3 B. Un documento de Word no es texto plano: incluye estructura y otros datos.
Practica
- Calcula el tamaño UTF-8 de «TIC 1» y «mañana», sin comillas ni salto de línea.
- Un texto contiene 900 caracteres ASCII y 100 letras acentuadas precompuestas que ocupan 2 B cada una. ¿Cuántos bytes ocupa?
- ¿Por qué «guardar como UTF-8» y «cambiar de fuente» resuelven problemas diferentes?
- Explica por qué ver «Ã±» donde esperabas «ñ» sugiere una interpretación incorrecta de bytes, pero no demuestra por sí solo que el archivo original estuviera dañado.
Comprueba tus respuestas
1. «TIC 1» ocupa 5 B, incluido el espacio; «mañana» ocupa 7 B. 2. 900 × 1 + 100 × 2 = 1.100 B. 3. UTF-8 fija la codificación; la fuente determina el dibujo disponible para los caracteres. 4. Los bytes C3 B1 de ñ en UTF-8 pueden interpretarse con otra codificación y producir ese texto; puede bastar leer el archivo con la codificación adecuada.
Qué debes recordar: para contar bytes de texto, necesitas conocer la codificación y la secuencia real.